 BTV (cũ)
 Tin
Tác phẩm của hàng nghìn tác giả danh tiếng, trong đó có Margaret Atwood, Haruki Murakami, Jonathan Franzen… đã được dùng làm nguồn đào tạo cho các ứng dụng AI do Meta và Bloomberg phát triển, tờ The Atlantic vừa tiết lộ.
Ngoài 3 tác giả trên còn có Zadie Smith, Stephen King, Rachel Cusk và Elena Ferrante... Theo một phân tích về Books3 – bộ dữ liệu được nhiều công ty khai thác để xây dựng các công cụ AI, hơn 170.000 đầu sách đã được đưa vào các mô hình nói trên, bao gồm Meta và Bloomberg.
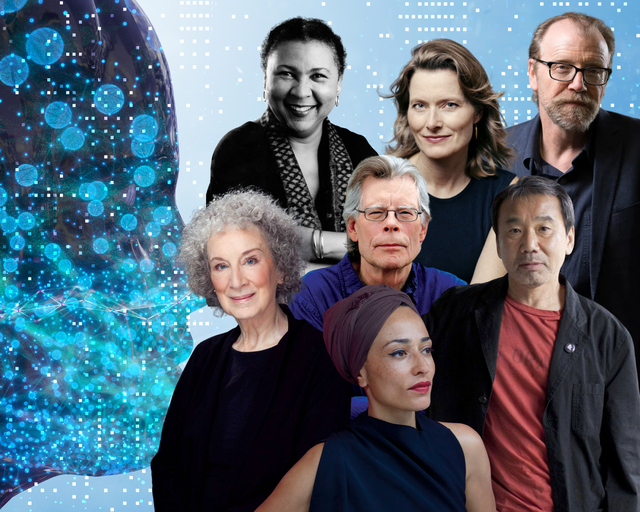
Bell hooks, Jennifer Egan, George Saunders, Stephan King, Margaret Atwood, Zadie Smith và Haruki Murakami nằm trong số nhà văn có tác phẩm bị dùng phi pháp để huấn luyện AI T.D tổng hợp
Theo đó, các ứng dụng AI sáng tạo như ChatGPT được thiết kế để hiểu và tạo văn bản giống như con người. Để đạt được điều này, hệ thống yêu cầu lượng lớn văn bản dùng để “đào tạo”. Theo nhà văn kiêm lập trình viên Alex Reisner, người đã tiết lộ sự thật chấn động trên, “đầu vào” đó không chỉ đến từ nguồn “mở” như Wikipedia và các bài báo trực tuyến, mà còn là từ sách vở để đảm bảo được chất lượng cao.
Số lượng sách dùng phi pháp cũng được "bật mí" gồm 33 cuốn của Margaret Atwood, ít nhất 9 cuốn của Haruki Murakami, 9 cuốn của bell hooks, 7 cuốn của Jonathan Franzen, 5 cuốn của Jennifer Egan và 5 cuốn của David Grann. |
Books3 được sử dụng để đào tạo LLaMA, một trong số các mô hình ngôn ngữ lớn của Meta – trong đó nổi tiếng nhất là ChatGPT của OpenAI – để có thể tạo ra nội dung dựa trên các mô thức mà nó học được từ văn bản đào tạo. Bộ dữ liệu cũng được sử dụng để đào tạo BloombergGPT của Bloomberg, GPT-J của EleutherAI và “có khả năng” cũng được sử dụng trong các mô hình AI khác.
Các đầu sách trong Books3 mới được tiết lộ là chứa khoảng 1/3 tiểu thuyết và 2/3 sách phi hư cấu, phần lớn được xuất bản trong 2 thập kỷ qua. Số lượng sách dùng phi pháp cũng được "bật mí" gồm 33 cuốn của Margaret Atwood, ít nhất 9 cuốn của Haruki Murakami, 9 cuốn của bell hooks, 7 cuốn của Jonathan Franzen, 5 cuốn của Jennifer Egan và 5 cuốn của David Grann.
Ngoài những tác giả kể trên, sách của George Saunders, Junot Díaz, Michael Pollan, Rebecca Solnit và Jon Krakauer cũng xuất hiện trong bộ dữ liệu này. Các tựa sách này rộng khắp các nhà xuất bản lớn và nhỏ, gồm hơn 30.000 tựa của Penguin Random House, 14.000 tựa của HarperCollins, 7.000 tựa của Macmillan, 1.800 tựa của Oxford University Press và 600 tựa của Verso...
Cuộc chiến của ngành công nghệ và giới xuất bản được dự đoán đang đến rất gần The Atlantic
Điều này theo sau vụ kiện đã được đệ trình vào tháng trước, bởi 3 nhà văn Sarah Silverman, Richard Kadrey và Christopher Golden, cáo buộc rằng các tác phẩm có bản quyền của họ “đã bị sao chép và được dùng như đầu vào để đào tạo các công cụ AI”. Phân tích cho thấy tác phẩm của 3 nguyên đơn nói trên thực sự là một phần của Books3.
OpenAI, công ty đứng sau AI chatbot ChatGPT, cũng bị cáo buộc đã đào tạo mô hình của mình trên các tác phẩm có bản quyền. Manh mối về dữ liệu này nằm trong báo cáo do công ty phát hành vào năm 2020 có đề cập đến hai “nguồn sách dựa trên internet”, một trong số đó là Books2 và ước tính chứa gần 300.000 đầu sách.
Dẫu vậy nhiều người nghi ngờ với số lượng tác phẩm lớn như thế, thì nguồn cung cấp chỉ có thể đến từ các “thư viện đen” như Library Genesis (LibGen) và Z-Library, nơi các dữ liệu được bảo mật hàng loạt thông qua hệ thống torrent. Đây vốn được biết như là nguồn sách không có bản quyền, có lượt truy cập lớn bởi độc giả trên khắp thế giới.
Shawn Presser, nhà phát triển AI độc lập, người ban đầu tạo ra Books3, chia sẻ với The Guardian rằng mình đồng cảm với mối quan tâm của các tác giả. Ông nói mình đã tạo ra cơ sở dữ liệu để bất kỳ ai cũng có thể phát triển công cụ AI và khá lo lắng về các rủi ro khi các công ty lớn nắm quyền kiểm soát công nghệ.
Cuộc điều tra do Reisner thực hiện nói trên cũng đã tiết lộ tập dữ liệu khổng lồ có tên The Pile, chứa dữ liệu Books3 cũng như tài liệu từ nhiều nguồn khác nhau, như phụ đề YouTube và các tài liệu của Nghị viện Châu Âu...
Dữ liệu của The Pile được Reisner trích xuất và phân tích đã phơi bày quy mô và tính đa dạng của các tác phẩm vi phạm bản quyền dùng để đào tạo AI, dẫn đến những lo ngại về mặt đạo đức đối với nguồn gốc và tính hợp pháp của dữ liệu này.
Reisner cũng cho biết trong khi người phát ngôn của Meta từ chối bình luận về việc sử dụng Books3, thì Stella Biderman, giám đốc điều hành của EleutherAI, không phủ nhận việc sử dụng nguồn dữ liệu này đối với GPT-J.
Mới đây, người phát ngôn của Bloomberg cũng xác nhận với The Guardian rằng công ty đã sử dụng tập dữ liệu này trong thời gian qua. Họ cam kết thêm: “Chúng tôi sẽ không đưa tập dữ liệu Books3 như nguồn đầu vào để đào tạo cho BloombergGPT sắp tới”.
Việc sử dụng sách có bản quyền để đào tạo các mô hình AI đã tạo ra những câu hỏi phức tạp về đạo đức, bản quyền và tương lai của các tác phẩm sáng tạo. Khi công nghệ AI tiếp tục phát triển, vấn đề nội dung phi pháp được dùng như là đầu vào cần thiết phải có một cách tiếp cận cân bằng và hợp pháp hơn. Và vấn đề thu hẹp khoảng cách giữa tính “mở” của phát triển AI với quyền của người sáng tạo, do đó, đòi hỏi một sự cân bằng để đảm bảo tiến bộ công nghệ không gây tổn hại đến quyền sở hữu trí tuệ. Kết quả là một cuộc đối đầu có thể đang đến rất gần giữa ngành công nghệ và giới xuất bản.
Theo Thanh niên
https://thanhnien.vn/tac-pham-cua-nhieu-nha-van-noi-tieng-bi-dung-trai-phep-de-huan-luyen-ai-185230823143220216.htm